seo优化_前端开发_渗透技术
一家不到20人的电商运营团队,某天早上发现所有社媒账号同时掉线,后台数据被批量删除,客户投诉电话瞬间涌入。事后排查,起因只是一位离职员工的VPN账号未及时注销,被前同事恶意利用。这不是孤例,而是中小团队反复上演的剧本:预算有限、人员紧张、没有专职安全负责人,事故往往从一个不起眼的“小疏忽”开始。复盘这起真实案例,不是为了制造焦虑,而是想帮你把已经踩过的坑,变成可复用的防御清单。
中小团队的安全事故通常不来自高级黑客,而是来自“以为不会发生”的日常环节:共享密码、默认端口开放、备份从未验证、离职交接只靠口头。本文基于一个典型的权限失控事件,拆解事故发生的完整链路,并给出每一步的具体修复动作。你不需要安全团队,也能在48小时内完成核心整改。
事故复盘:权限失控如何一步步演变成数据删除
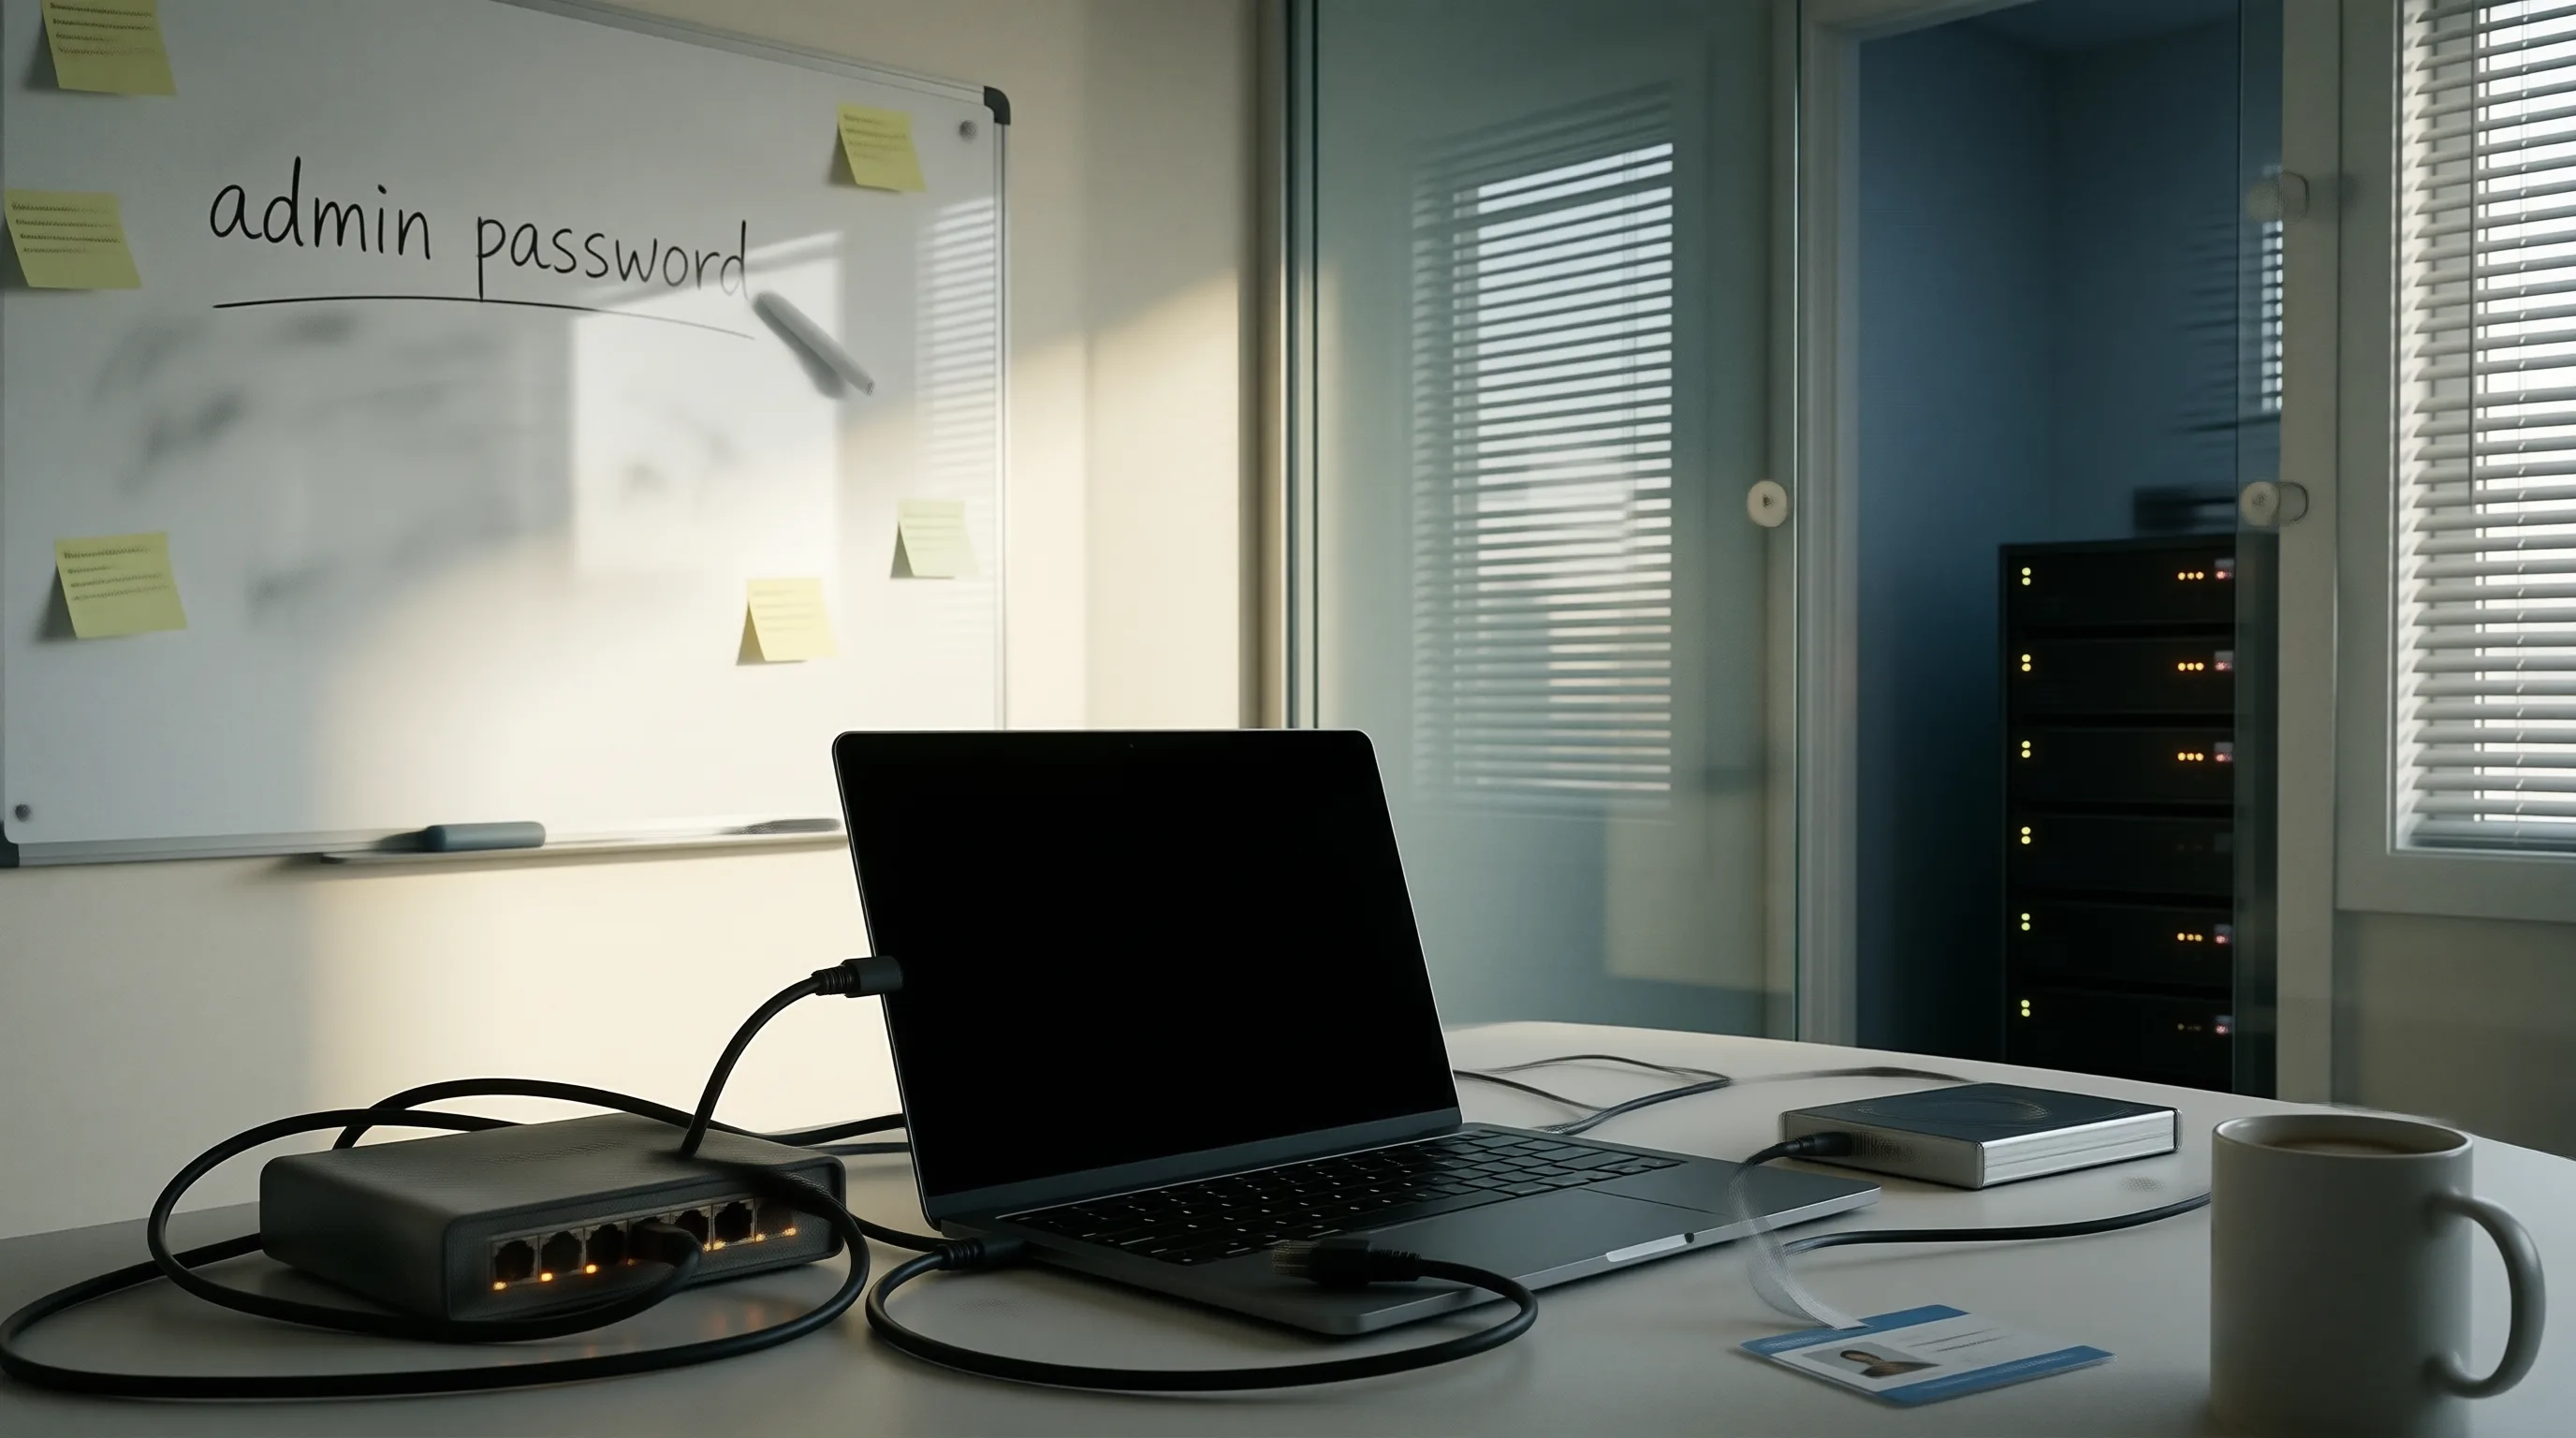
事故发生前,这家团队的权限结构极其简单:所有运营人员共用一个管理员账号,密码贴在茶水间的白板上。离职流程只涉及归还电脑,没有IT环节。当那位心怀不满的前员工用旧VPN连上内网时,他发现自己依然拥有数据库的读写权限,于是用脚本批量清空了客户表。从登录到删除完成,全程不到7分钟,而监控系统因为阈值设置过高,一条告警都没触发。
复盘时我们发现,权限失控的起点不是技术漏洞,而是管理习惯:管理员账号没有分级,离职清单没有“禁用账号”这一项,备份策略只做了本地拷贝却没有异地容灾。当这些“小问题”叠加在一起,事故就从偶然变成了必然。
四个被忽视的高危环节:账号、端口、备份与监控
账号管理方面,中小团队最容易犯的错误是“多人一密”。一旦任何一人离职或设备失窃,所有关联系统都会瞬间失守。端口暴露则是另一个重灾区:为了方便远程调试,团队把数据库的3306端口直接映射到公网,且防火墙规则长期未更新。备份环节同样脆弱,很多团队以为拷贝到另一台内网机器就算备份,却从没验证过恢复流程,真到用时才发现备份文件早已损坏。
监控缺位则是压垮骆驼的最后一根稻草。没有登录失败告警、没有异常流量提示、没有操作审计,事故发生后只能靠人工翻日志,往往错过最佳止损窗口。这四个环节环环相扣,任何一环断裂,都会让整条防线形同虚设。
48小时紧急止血:从混乱到可控的实操步骤
事故发生后,团队在48小时内完成了以下动作,将损失控制在最小范围:第一步,立即切断外网访问,拔掉受影响服务器的网线,防止二次破坏;第二步,强制重置所有账号密码,并启用多因素认证,确保即使密码泄露也无法直接登录;第三步,从一周前的离线备份中恢复数据,虽然丢失了两天新增订单,但核心客户信息得以保全;第四步,临时关闭非必要端口,仅保留80和443,并设置IP白名单。
完成紧急止血后,团队没有停下来,而是继续推进长期整改:建立账号生命周期模板,所有新员工入职当天自动创建独立账号,离职当天自动禁用;部署开源监控工具,对异常登录、批量导出、高危命令进行实时告警;每季度进行一次恢复演练,确保备份可真正可用。这些动作并不昂贵,却能在下一次危机到来时,把“7分钟删库”变成“7分钟恢复”。
长期防线:用最小成本建立可持续的安全习惯
中小团队没有预算购买昂贵的安全产品,但完全可以用“习惯+工具”替代。第一,把安全动作嵌入日常流程:代码提交前跑一遍敏感信息扫描,发布前检查依赖漏洞,把“安全”变成上线前的默认步骤。第二,用免费或开源方案覆盖核心风险:Let’s Encrypt提供零成本HTTPS,Fail2ban防暴力破解,Prometheus+Grafana做基础监控,这些工具的组合足以挡住90%的常见攻击。第三,把安全责任分散到每个人,而不是压在某个“懂技术”的同事身上。
最后,把复盘文档沉淀为团队知识。每次事故后,用“时间线-影响-根因-修复-预防”五栏记录,下次再遇到类似场景,就能按图索骥,而不是从头慌乱。安全不是一次性项目,而是一套需要每天运转的操作系统。当你把检查清单、恢复演练、权限审计变成肌肉记忆,事故就从“会不会发生”变成了“什么时候发生,我们都能接住”。